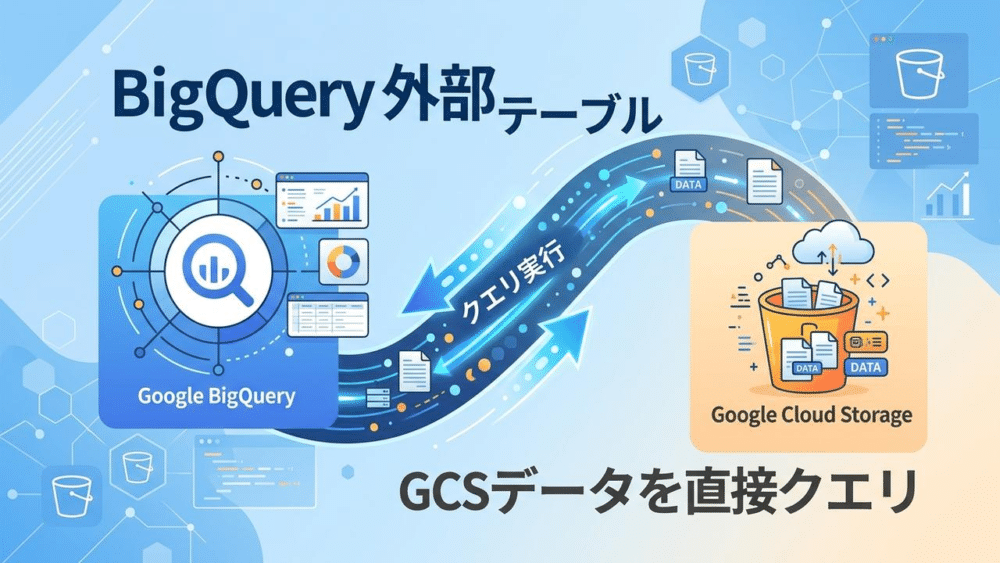
Google Cloud Storage(GCS)に保存されたデータをBigQueryで分析する際、通常は「データをBigQueryのネイティブテーブルにロード」して使用します。 しかし、「ETL処理前のデータをちょっとプレビューしたい」「日次で吐き出される大量のログファイルをいちいちロードしたくない」というケースもあるでしょう。
そんな時に便利なのが、BigQueryの外部テーブル(External Table)機能です。
本記事では、GCS上のCSVやParquetファイルをBigQueryにロードすることなく、直接SQLでクエリできる「外部テーブル」の作成手順を解説します。複数ファイルの結合や、スキャンコストを削減するHiveパーティショニングの設定方法、さらには利用時の制限事項まで網羅しました。
1. BigQueryの「外部テーブル」とは?
外部テーブルとは、データの実体はBigQueryのストレージではなくGCSなどの外部ストレージに置いたまま、BigQueryからSQLで検索できる仮想的なテーブルのことです。
ネイティブテーブル(データをBigQuery内にロードしたテーブル)と比較すると、以下のような特徴があります。
| 項目 | 外部テーブル | ネイティブテーブル |
|---|---|---|
| データの場所 | GCSなどの外部ストレージ | BigQueryマネージドストレージ |
| ロードの手間 | 不要(即座にクエリ可能) | 必要(ジョブ実行など) |
| クエリの速度 | ネイティブに比べて遅い | 高速(ストレージの最適化が効く) |
| DML(更新・削除) | 不可(読み取り専用) | 可能 |
| コスト | GCSの保存費用 + BQのクエリスキャン費用 | BQの保存費用 + BQのクエリスキャン費用 |
外部テーブルが適しているケース
頻繁に更新されるログファイルの集計や、ETLパイプラインを構築する前のデータ探索(プレビュー)、たまにしか検索しない過去データのアーカイブ用途などに最適です。
2. 外部テーブルの作成手順(SQL構文)
外部テーブルは、Google Cloudコンソールの画面上からも作成可能ですが、再現性や自動化の観点から CREATE EXTERNAL TABLE 構文を使用したSQLでの作成がおすすめです。
CSVファイルを読み込む場合
CSVファイルの場合は、カンマ区切りであることやヘッダー行のスキップなどをオプションで指定します。
CREATE OR REPLACE EXTERNAL TABLE `my_project.my_dataset.my_external_csv`
OPTIONS (
  format = 'CSV',
  uris = ['gs://my-bucket/data/sample.csv'],
  skip_leading_rows = 1 -- ヘッダー行をスキップ
);
Parquetファイルを読み込む場合
Parquet(列指向フォーマット)は、スキーマ情報がファイル内に含まれているため、よりシンプルに定義できます。また、BigQueryとの相性も良く、CSVよりスキャン効率やパフォーマンスが高くなります。
CREATE OR REPLACE EXTERNAL TABLE `my_project.my_dataset.my_external_parquet`
OPTIONS (
  format = 'PARQUET',
  uris = ['gs://my-bucket/data/sample.parquet']
);
3. 複数ファイルの一括読み込み(ワイルドカードURI)
特定のディレクトリ以下にある複数のファイル(日別のログファイルなど)をまとめて1つのテーブルとして扱いたい場合は、uris オプションにワイルドカード(*)を指定します。
CREATE OR REPLACE EXTERNAL TABLE `my_project.my_dataset.my_daily_logs`
OPTIONS (
  format = 'CSV',
  uris = ['gs://my-bucket/logs/2026/*.csv'], -- 2026年配下の全CSVを対象
  skip_leading_rows = 1
);
このように指定することで、gs://my-bucket/logs/2026/ 配下に新しくCSVファイルが追加されても、自動的にクエリの対象に含まれるようになります。
4. Hiveパーティショニングによるスキャン削減法
外部テーブルの最大の弱点は、クエリ実行時に「対象となる全ファイルを都度フルスキャンしてしまう」ことです。データ量が増えるとクエリコストが増大し、パフォーマンスも低下します。
これを解決するのが、Hiveパーティショニングです。 GCS上のファイル配置を gs://my-bucket/logs/year=2026/month=10/ のような キー=値 のディレクトリ構造にしておくことで、BigQuery側で不要なディレクトリの読み込みをスキップ(プルーニング)させることができます。
Hiveパーティションを有効にしたテーブル作成
CREATE OR REPLACE EXTERNAL TABLE `my_project.my_dataset.partitioned_logs`
(
  -- ファイル内のカラム定義
  id STRING,
  message STRING,
  -- パーティションキーの定義
  year INT64,
  month INT64
)
WITH PARTITION COLUMNS (
  year INT64,
  month INT64
)
OPTIONS (
  format = 'PARQUET',
  uris = ['gs://my-bucket/logs/*'],
  hive_partition_uri_prefix = 'gs://my-bucket/logs/' -- 基準となるパス
);
上記のように定義したテーブルに対して、以下のようなクエリを実行します。
SELECT *
FROM `my_project.my_dataset.partitioned_logs`
WHERE year = 2026 AND month = 10;
すると、BigQueryは year=2026/month=10/ のディレクトリにあるファイルだけをスキャンするため、大幅なコスト削減と高速化が実現します。
【注意】パーティションキーとカラム名の重複
Hiveパーティショニングを利用する場合、ファイル内のカラム名とパーティションキー(year や month など)が重複しないように注意してください。
5. 制限事項とネイティブテーブルへの移行タイミング
便利な外部テーブルですが、利用する際には以下の制限事項を理解しておく必要があります。
- 読み取り専用:
INSERT,UPDATE,DELETE,MERGEなどのDML文は実行できません。データを変更したい場合は、GCS上のファイルを直接置き換える必要があります。 - 機能制限: テーブルのコピー(Copy Job)やクラスタリング機能はサポートされていません。
- パフォーマンスの限界: Hiveパーティションを使っても、最終的には外部ストレージからのフェッチになるため、ネイティブテーブルの速度には及びません。また、クエリのキャッシュが効きにくい点にも注意が必要です。
ネイティブテーブルへの切り替えタイミングは?
以下のような要件が出てきた場合は、外部テーブルからネイティブテーブルへデータを取り込む(ロードする)構成への切り替えを推奨します。
- DASHBOARDやBIツールと連携する場合: 頻繁にクエリが実行されるため、ネイティブテーブルのキャッシュと高速なレスポンスが必須になります。
- データ加工(DML)が必要な場合: 抽出したデータを元に新しいテーブルを生成・更新する処理が必要な場合。
- より高度なアクセス制御が必要な場合: (※近年では「BigLakeテーブル」を利用することで、外部データでも細かいアクセス制御が可能になっていますが、基本的にはネイティブの方が管理が容易です)。
まとめ
BigQueryの「外部テーブル」は、GCS上のデータを手軽にクエリできる非常に強力な機能です。
- ETL不要で即座にデータプレビューや分析が可能
- ワイルドカード指定で複数ファイルを簡単に結合
- Hiveパーティショニング(
year=.../month=...)でスキャン量とコストを削減
これらの特性と制限事項を正しく理解し、ネイティブテーブルと上手く使い分けることで、より効率的なデータ分析基盤を構築していきましょう。